Nutanix Cloud Manager™ に含まれる Intelligent Operations による、仮想マシンのリソース最適化、キャパシティ予測、レポート作成、異常検知、X-Play/Playbook による運用自動化についてご紹介いたします。
- ライター:榎本 真弓
- Broadcom 及びNutanix の仮想化製品の導入を推進しております。各製品の技術Updateや使い方など、有益な情報をお届けできればと思っています。
・VMware vExpert 2020-2026、Broadcom Knight
・Nutanix Partner Elite Member
目次
Nutanix Cloud Manager(NCM)Intelligent Operations による運用管理の高度化
近年、仮想化基盤やプライベートクラウド環境では、システムの安定稼働に加え、運用負荷の軽減、リソース利用の最適化、キャパシティ予測、障害や性能劣化の早期検知など、より高度な運用管理が求められています。
また昨今では、サーバーやストレージなどのハードウェア調達において、納期が長期化するケースも見られます。リソース不足が顕在化してから増設を検討した場合、必要なタイミングでハードウェアを用意できず、システムの拡張や新規ワークロードの受け入れに影響が出る可能性があります。そのため、キャパシティを「足りなくなってから確認する」のではなく、将来の需要を見据えて継続的に把握し、余裕を持ってハードウェアの増設やリソースの最適化を検討することが重要です。
一方、従来の運用では、仮想マシンごとのリソース利用状況、過剰割り当て、クラスタの空き容量、将来の増設判断、異常検知時の対応などを、管理者が個別に確認・判断するケースも多く、運用の属人化や判断の遅れが課題となります。
特に、仮想マシン数が増加した環境では、すべてのVMの状態を継続的に把握し、適切なサイジングや運用改善につなげることは容易ではありません。また、固定しきい値による従来型の監視では、VMごとの通常動作の違いを十分に考慮できず、誤検知や検知漏れにつながる可能性があります。
こうした課題に対応するには、仮想化基盤全体の状態を可視化し、リソースの最適化候補や将来のキャパシティ不足を把握し、必要に応じて運用タスクを自動化できる仕組みが重要となります。
これらの要件に対応する機能が、Nutanix Cloud Manager™ に含まれる Intelligent Operations です。Intelligent Operations を利用することで、VMのライトサイジング、キャパシティ予測、レポート作成、パフォーマンス異常検知、X-Play/Playbookによる運用自動化などを、Prism Central™ から一元的に利用できます。
本記事では、AOS 7.0.0.5 および Prism Central pc.2024.3.0.1 の検証環境で実施した動作確認の結果を踏まえ、Nutanix Cloud Manager (NCM) Intelligent Operations が提供する主要な機能と活用方法についてご紹介いたします。
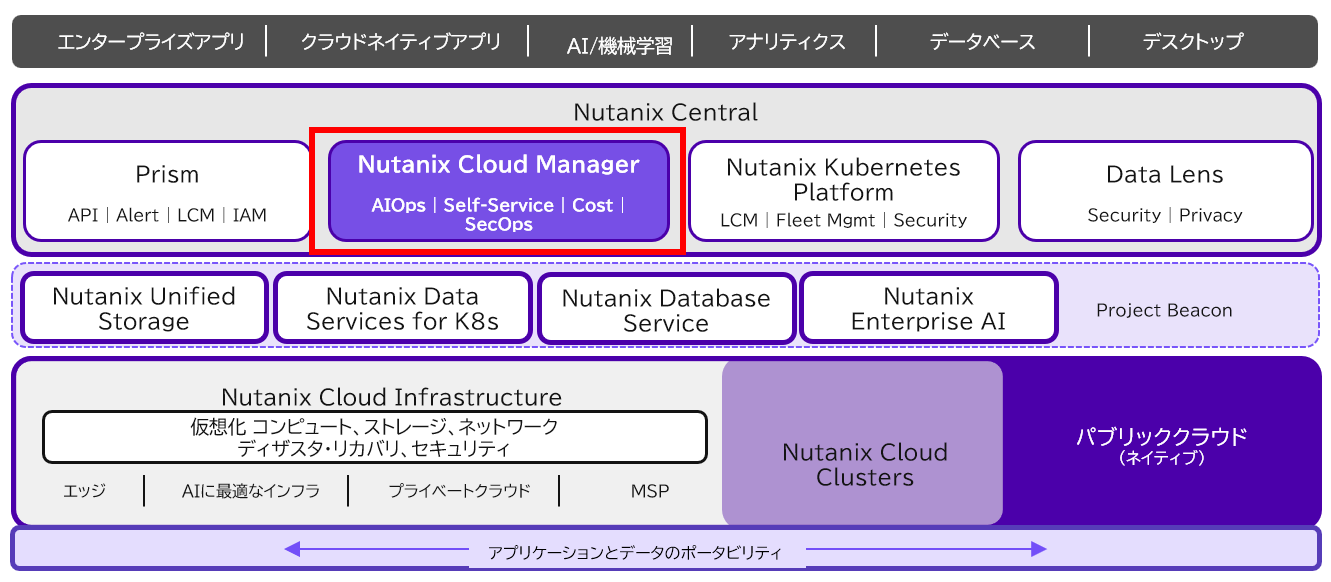
NCM Intelligent Operations とは
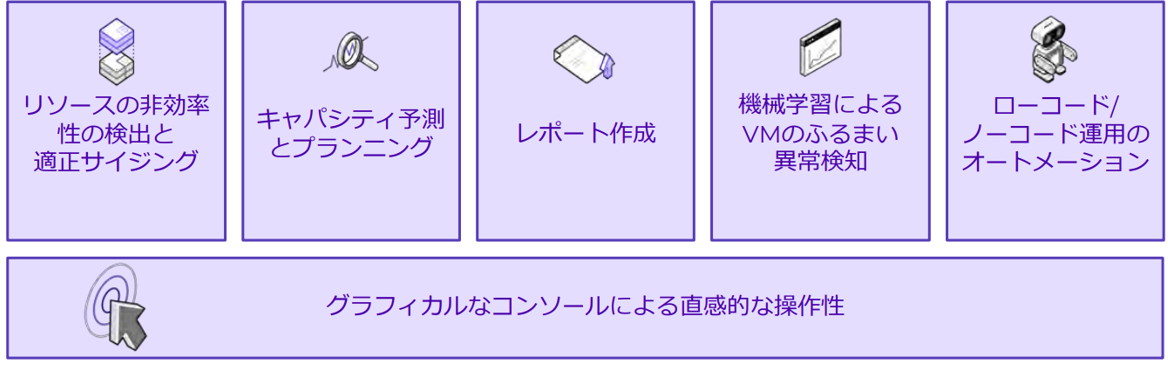
NCM Intelligent Operations は、Nutanix Cloud Manager(NCM)に含まれる運用支援機能です。Nutanix環境におけるリソース使用状況やパフォーマンス情報をもとに、仮想マシンの最適化、キャパシティの予測、異常検知、レポート作成、運用自動化などを実現します。
主な機能は以下の通りです。
- VMリソースのライトサイジング
- キャパシティ予測とプランニング
- レポート作成
- パフォーマンス異常検知
- X-Play/Playbookによる運用自動化
以降では、これらの機能について順番にご紹介いたします。
Intelligent Operations の有効化
Intelligent Operations は、Prism Central から有効化します。
- Prism Central > Admin Center > 設定 > Intelligent Operations より「Allocate & Enable」で、Intelligent Operations 機能を有効化
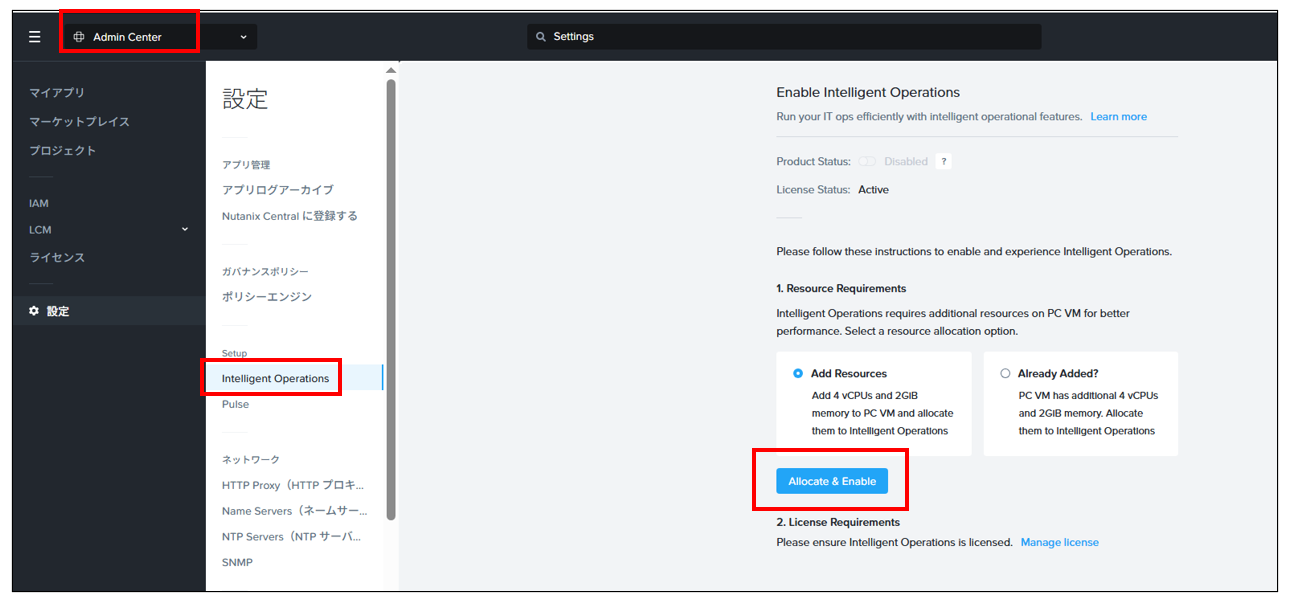
本検証環境では、Intelligent Operations の有効化により Prism Central に 4vCPU、2GiB RAM が追加されることを確認しています。環境設計時には、Intelligent Operations の利用の有無に応じて、Prism Central のリソース要件を考慮する必要があります。
仮想マシンの最適化機能
Intelligent Operations の代表的な機能の1つが、仮想マシンの最適化機能です。
Intelligent Operations の Operations Dashboard 画面からリソースが過剰に割り当てられているVMや、長期間利用されていないVMなどを一覧で確認できます。
- VM Efficiency による分類
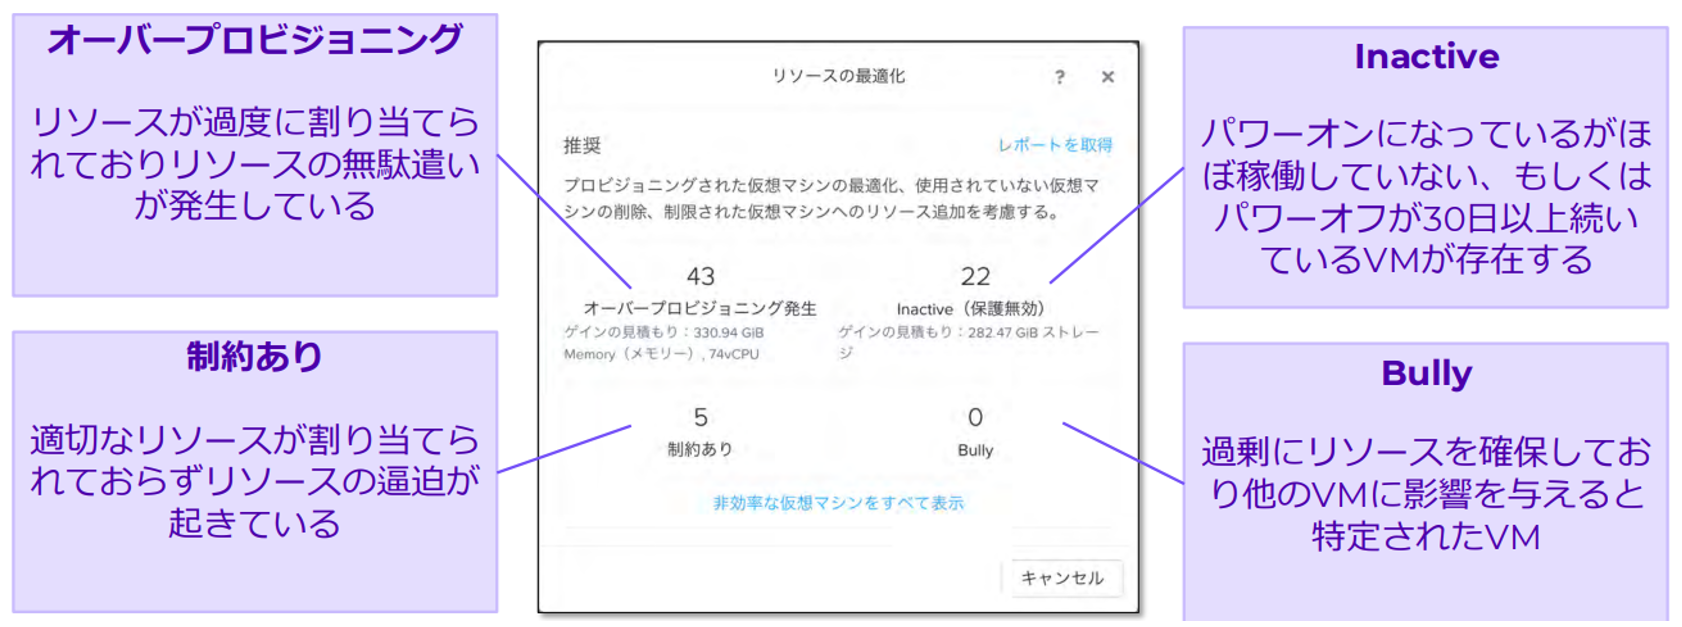
- Prism Central > Intelligent Operations > Operations Dashboard > VM Efficiency
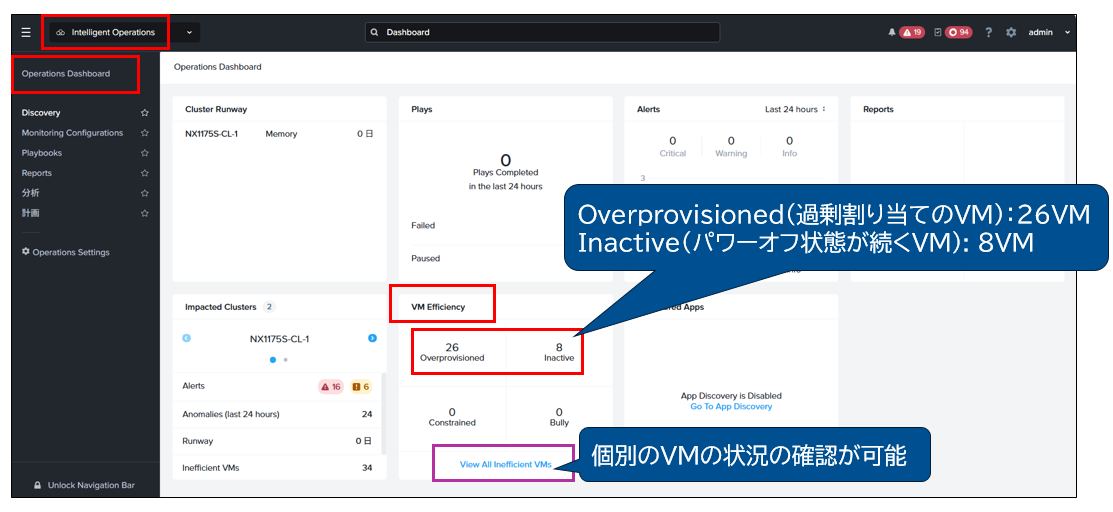
- 上記画面で「View All Inefficient VMs」を選択する事で、個別VMの状況を確認出来ます。
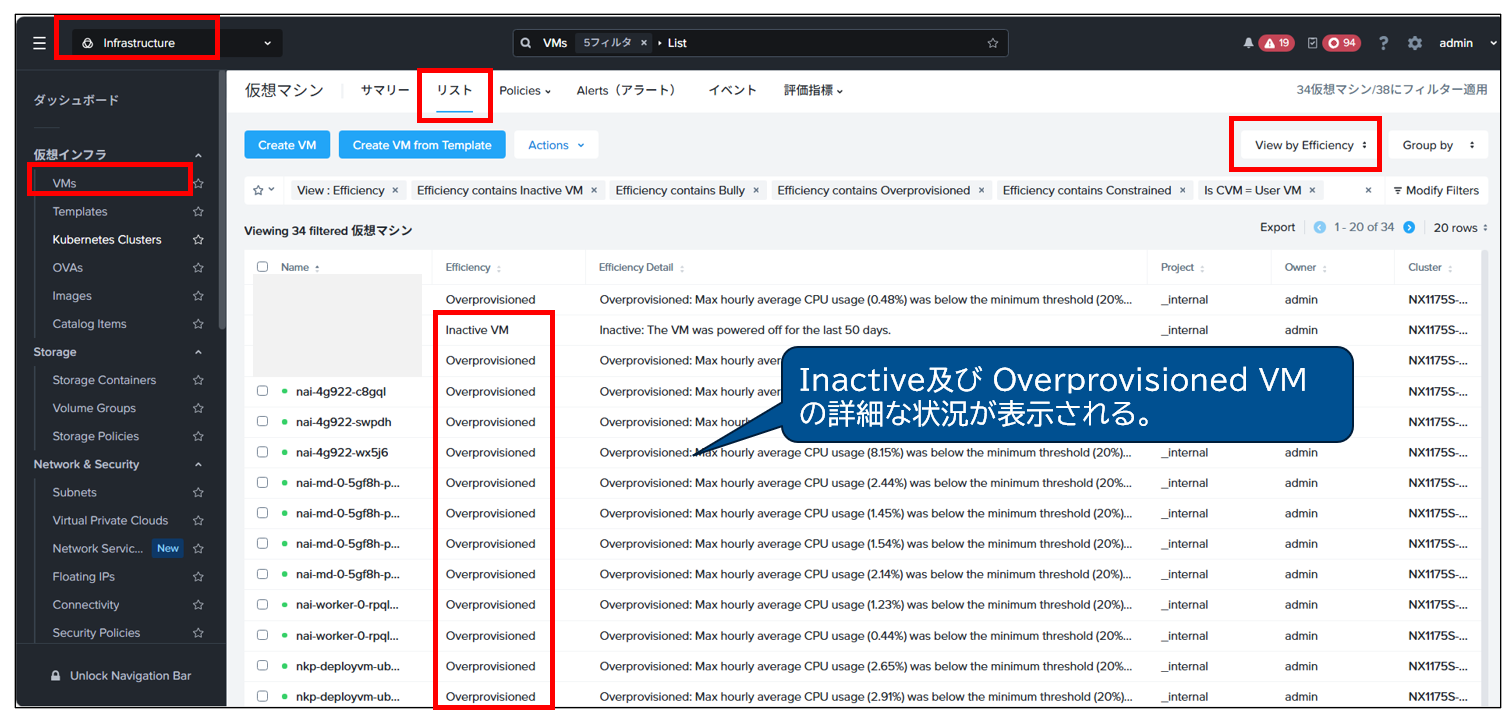
例えば、CPUやメモリが実際の利用量に対して大きく割り当てられているVMは、Overprovisioned として表示されます。また、長期間パワーオフ状態が続いているVMは Inactive として確認できます。これにより、管理者はクラスタ全体のリソース利用状況を把握し、不要なリソース割り当ての見直しや、利用されていないVMの整理を検討できます。
検出された仮想マシンへの対応は、管理者による手動対応に加え、Playbook を利用した定型作業の自動化も可能です。例えば、Overprovisioned と判断されたVMに対して、メンテナンス時間帯にCPUやメモリを削減する処理を Playbook として定義できます。ただし、業務影響を考慮し、実運用では管理者確認後に実行する運用が現実的です。
仮想マシンのリソースは、導入時には余裕を持って割り当てられることが多い一方で、実際の利用状況に応じた見直しが行われないまま運用されるケースもあります。Intelligent Operations の VM Efficiency は、こうしたリソースの見直しを継続的に行うための有効な可視化機能となります。
キャパシティ予測とプランニング
Intelligent Operations では、クラスタのキャパシティ予測とプランニング機能も提供されます。
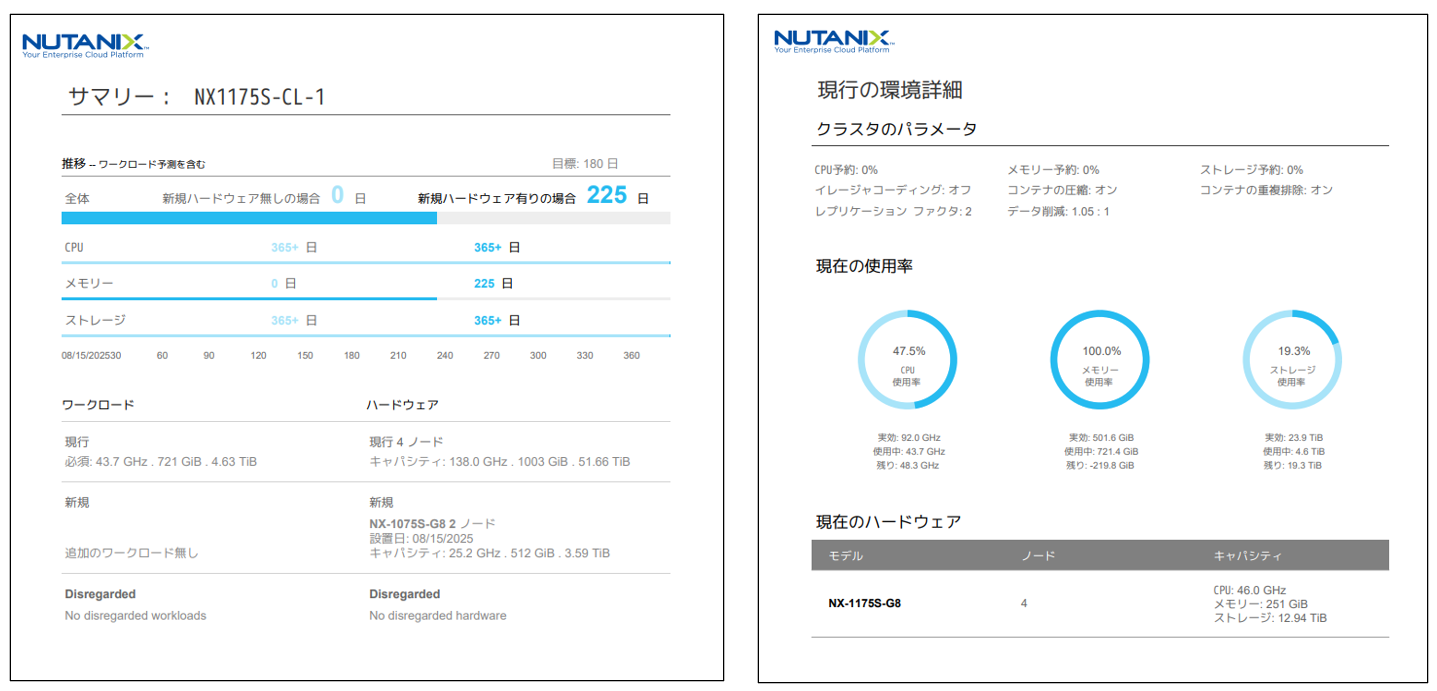
キャパシティ予測機能では、クラスタのCPU、メモリ、ストレージの利用状況をもとに、現在の利用傾向が継続した場合に、どの程度の期間リソースに余裕があるかを確認できます。この期間は「容量のランウェイ」として表示されます。
利用率が低く、十分な余裕があるクラスタでは、リソース枯渇まで1年以上の余裕があるといった形で表示されます。一方、仮想マシンによるリソース使用量が多いクラスタでは、リソース枯渇の可能性がある状態として表示されます。
- Intelligent Operations > 計画 > 容量のランウェイ > クラスタ名の選択
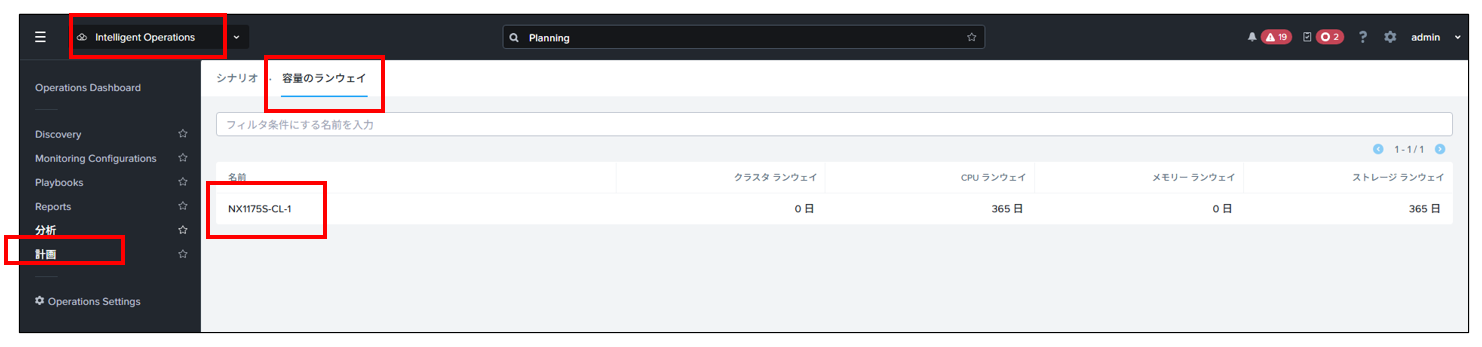
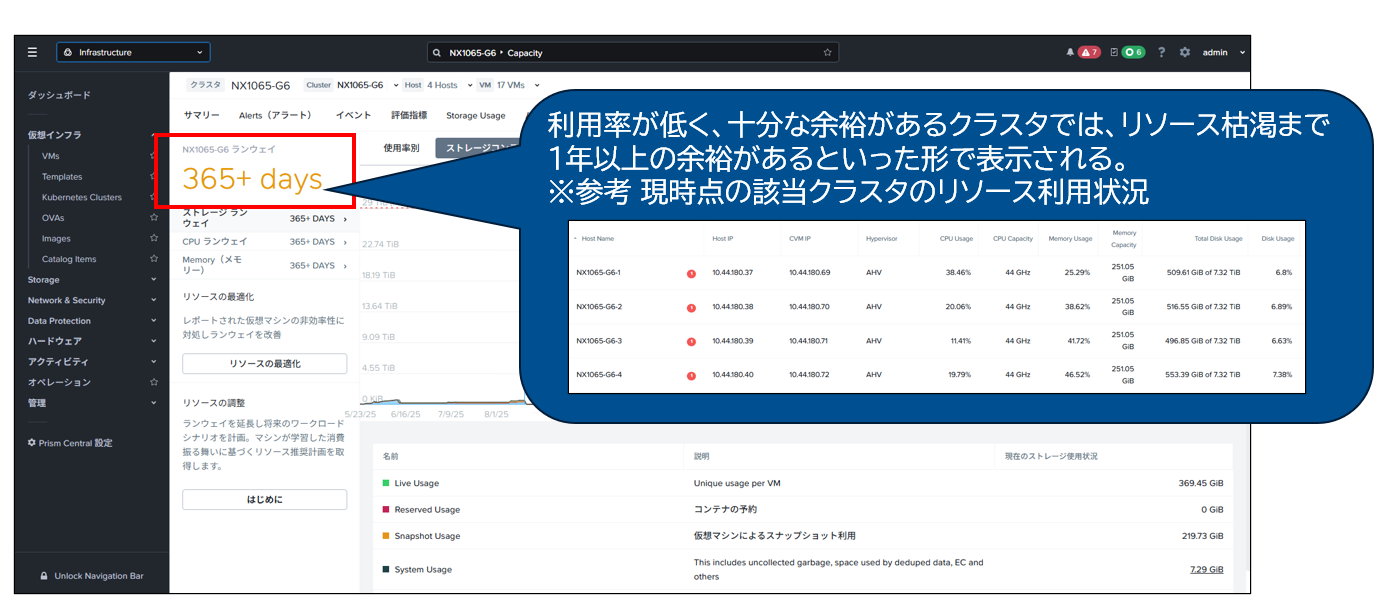
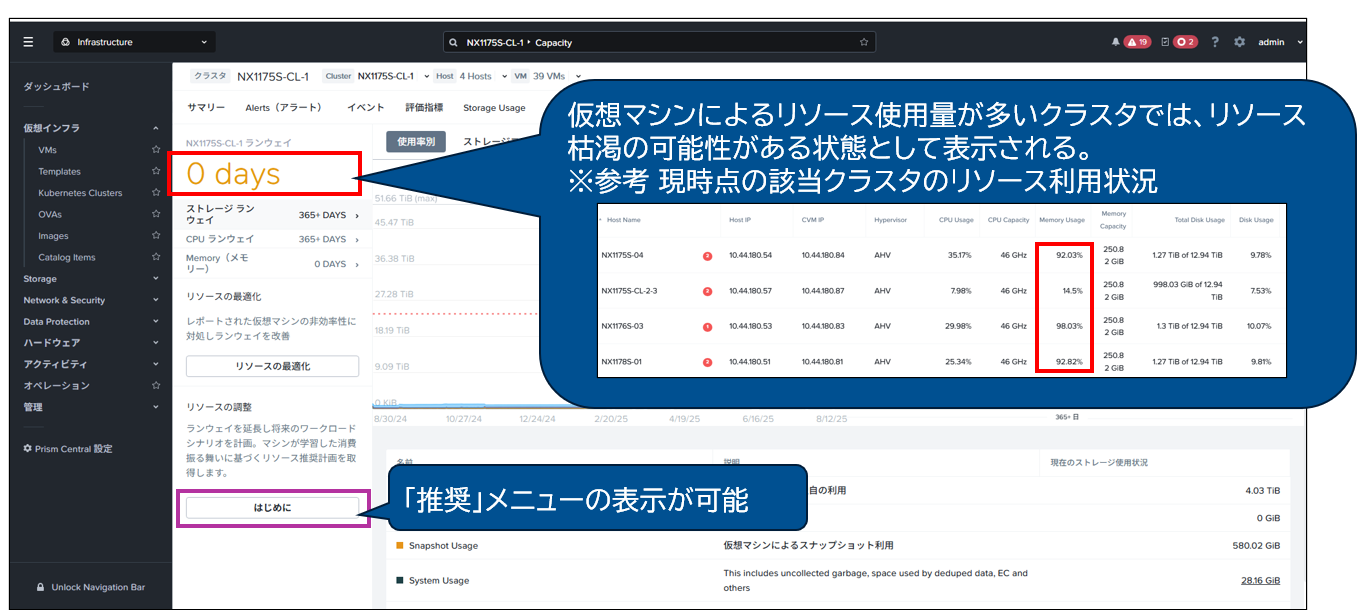
リソース不足が見込まれる場合は、上記画面で「はじめに」を選択の上、「推奨」メニューから、目標とする期間を指定して、追加リソースの目安を確認できます。例えば、今後6か月の需要を満たすために、追加で何ノード程度が必要かといった推奨結果を確認できます。
- ターゲットに目標とする期間を選択の上(例:6か月)、「推奨」を選択します。
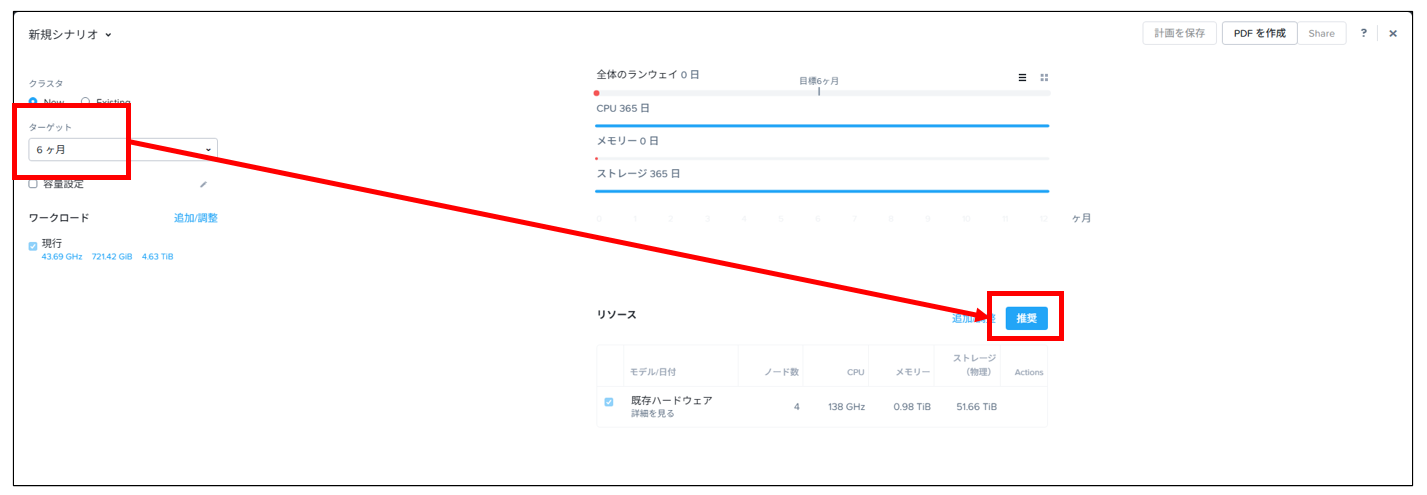
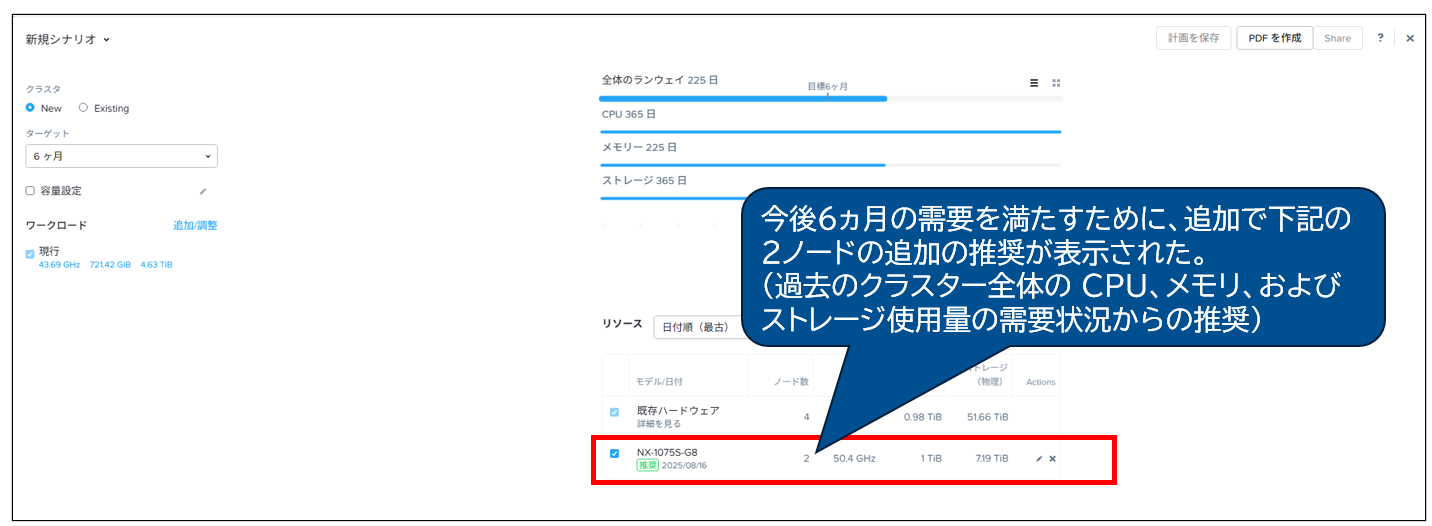
ただしこの推奨結果は、あくまで過去のCPU、メモリ、ストレージ使用量の傾向をもとに算出されるものとなります。そのため、実際の増設や発注を行う際には、将来のシステム計画、業務要件、保守方針などを踏まえたうえで、Nutanix Sizer 等を用いた正確なサイジングを実施することが重要です。
キャパシティ予測は、日々の運用確認だけでなく、来期の予算化や設備増強計画、クラスタ統合・移行計画の検討にも活用できます。従来、経験や個別の集計作業に依存していたキャパシティ判断を、より客観的なデータに基づいて行える点が大きなメリットとなります。
レポート作成機能
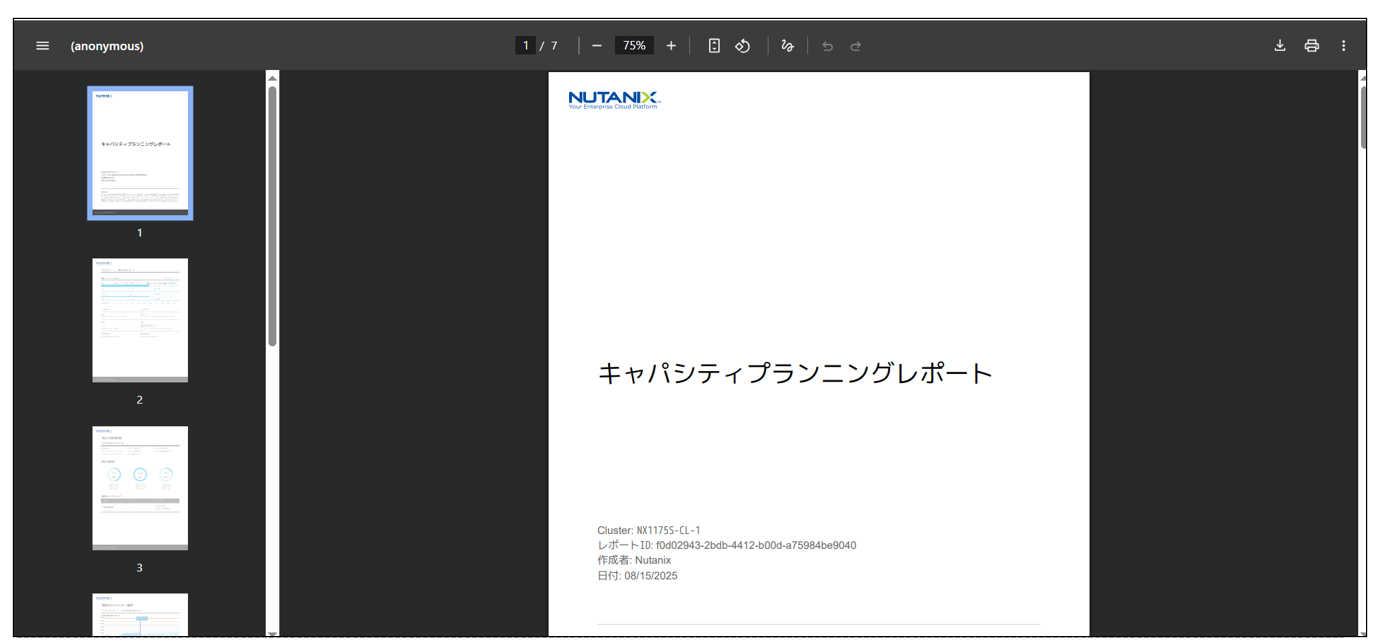
Intelligent Operations では、キャパシティや推奨結果をPDFレポートとして出力することも可能です。
レポートを利用することで、クラスタの現状や将来予測、推奨される追加リソースなどを、関係者へ共有しやすい形で整理できます。特に、運用担当者だけでなく、システムオーナーや管理部門、予算承認者などに対して、現状のリソース状況や将来的な増強の必要性を説明する場面では、画面上の情報だけではなく、資料として出力できることが有効です。
VMのふるまい異常の検知
Intelligent Operations では、VMのふるまい異常を検知する動的監視機能も利用できます。
従来の監視では、CPU使用率が80%を超えたらアラートを上げる、といった固定しきい値ベースの監視が一般的です。しかし、アプリケーションやVMごとに通常時の負荷傾向は異なるため、同じしきい値をすべてのVMに適用すると、誤検知や検知漏れにつながる可能性があります。
例えば、日中は一時的にCPU使用率が高くなることが通常動作であるVMもあれば、夜間に突然CPU使用率が大きく上昇することが異常の兆候となるVMもあります。このように、VMごとの「普段の状態」を踏まえた監視が求められます。
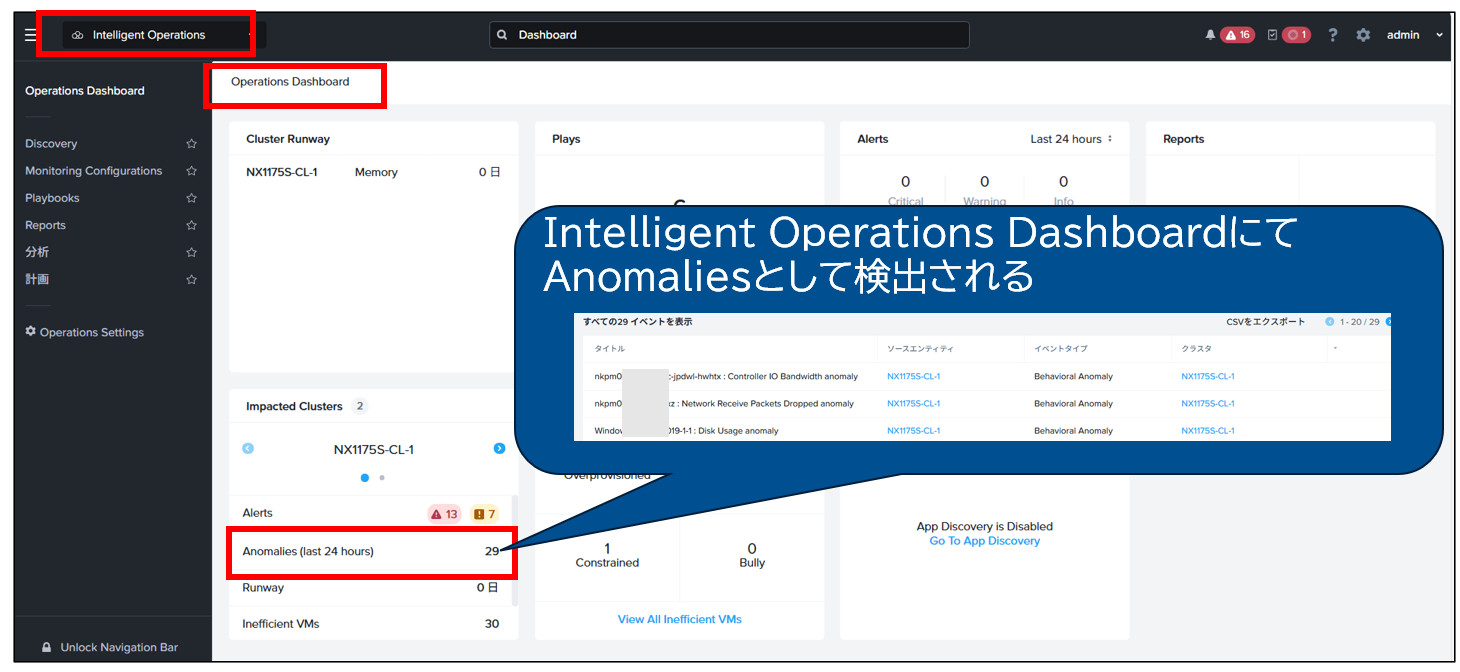
Intelligent Operations の動的監視機能では、AI/機械学習を活用し、VMごとの通常の動作傾向をもとに、普段と異なるふるまいを異常として検出します。検出された異常は、Intelligent Operations Dashboard 上で Anomalies として確認できます。
なお、検出された異常は推奨情報として表示されるため、実際の対応は管理者が内容を確認したうえで判断する必要があります。固定しきい値の監視に加えて、動的監視を活用することで、より実態に即した運用監視を実現できます。
X-Play/Playbook による運用自動化
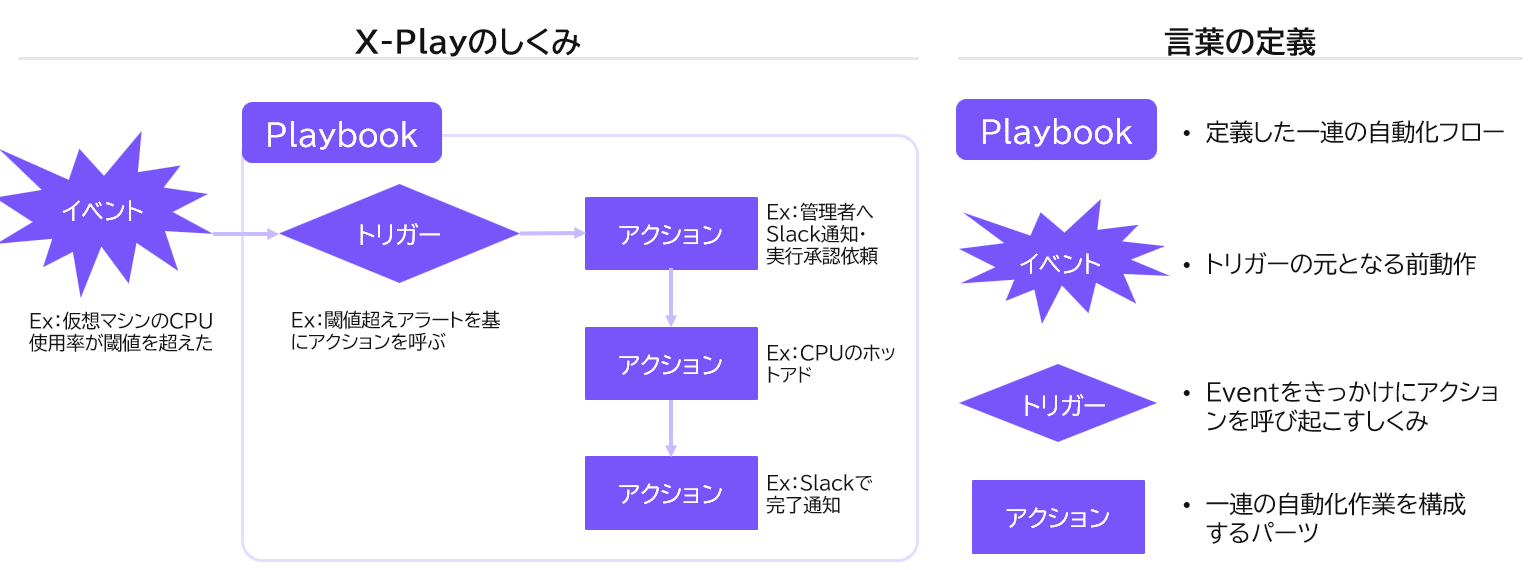
Intelligent Operations には、X-Play と呼ばれる運用自動化用のエンジンが含まれます。Playbook は、X-Play 上で作成する個別の自動化ワークフローです。
Playbook は、イベント、トリガー、アクションの組み合わせで構成されます。イベントは、アラート発生などの契機となる事象です。トリガーは、そのイベントを契機としてPlaybook を起動する条件です。アクションは、実際に実行される処理です。
例えば、特定のVMのCPU使用率が一定以上になった場合にアラートを発生させ、そのアラートをトリガーとして、対象VMにCPUを追加し、管理者へ通知するといった自動化を構成できます。
X-Play/Playbook を利用することで、スクリプトを一から作成しなくても、画面上でトリガーやアクションを組み合わせ、定型的な運用作業を自動化できます。
Playbook による CPU Hot Add の検証
Playbookに関する検証として、CPU負荷が高いVMに対して、PlaybookによりCPUを Hot Add する動作を確認しました。
まず、対象VMのCPU使用率が90%を超えた場合にCriticalアラートを上げるカスタムアラートポリシーを作成します。
- Prism Central > Infrastructure > Alerts > Alert Policies > User Definedを選択
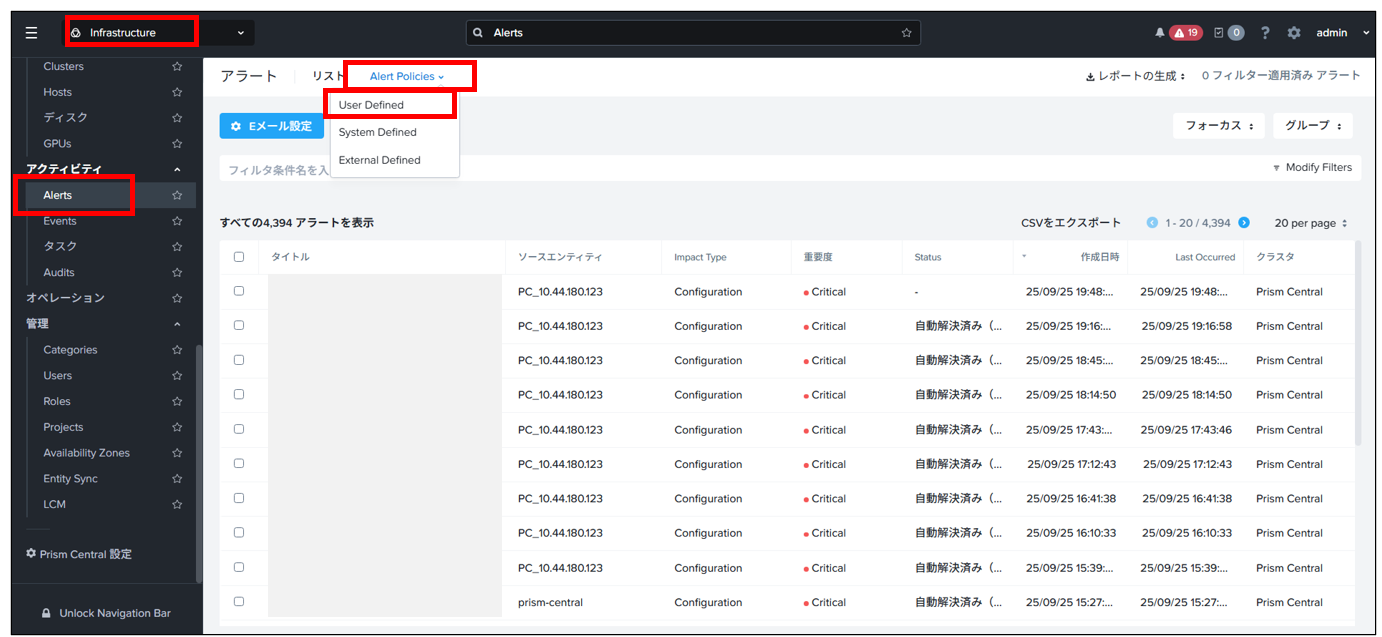
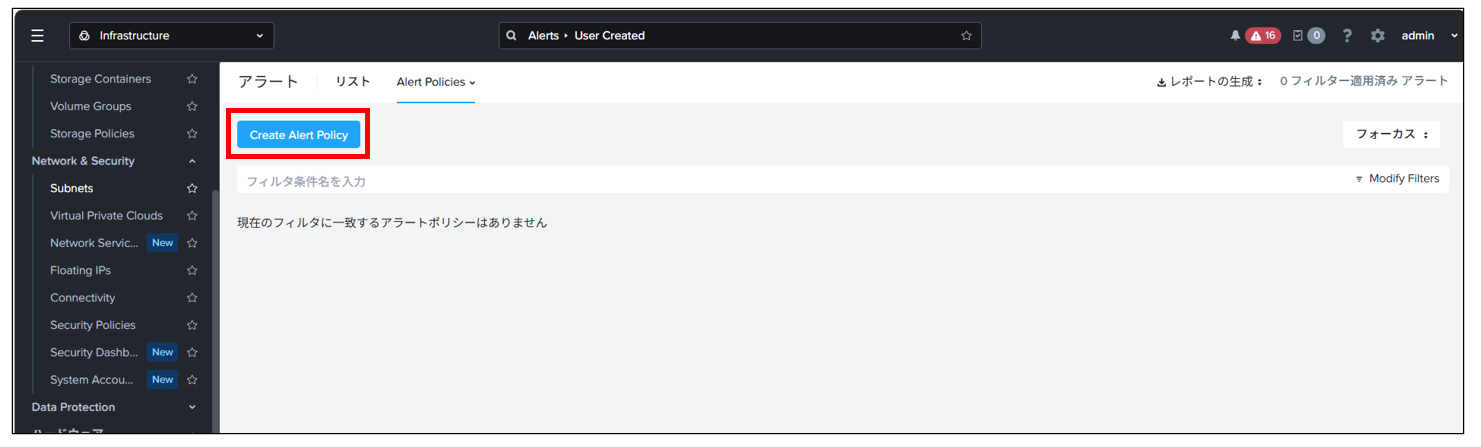
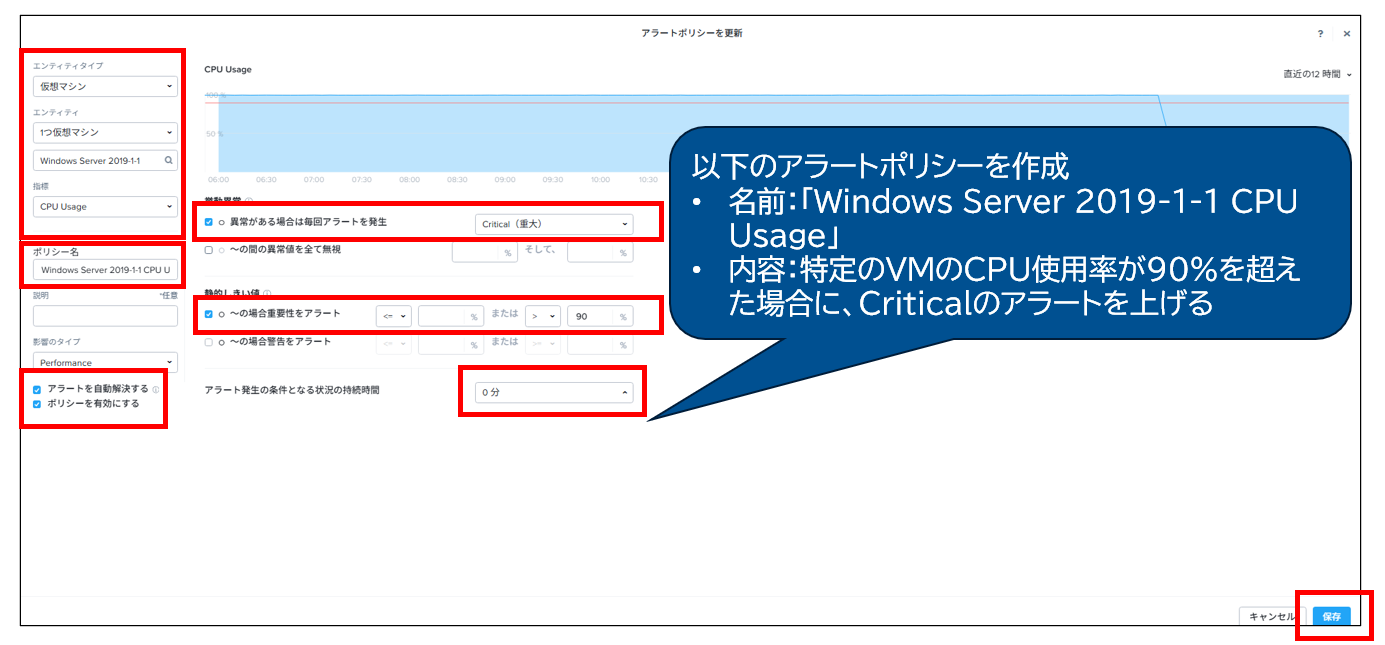
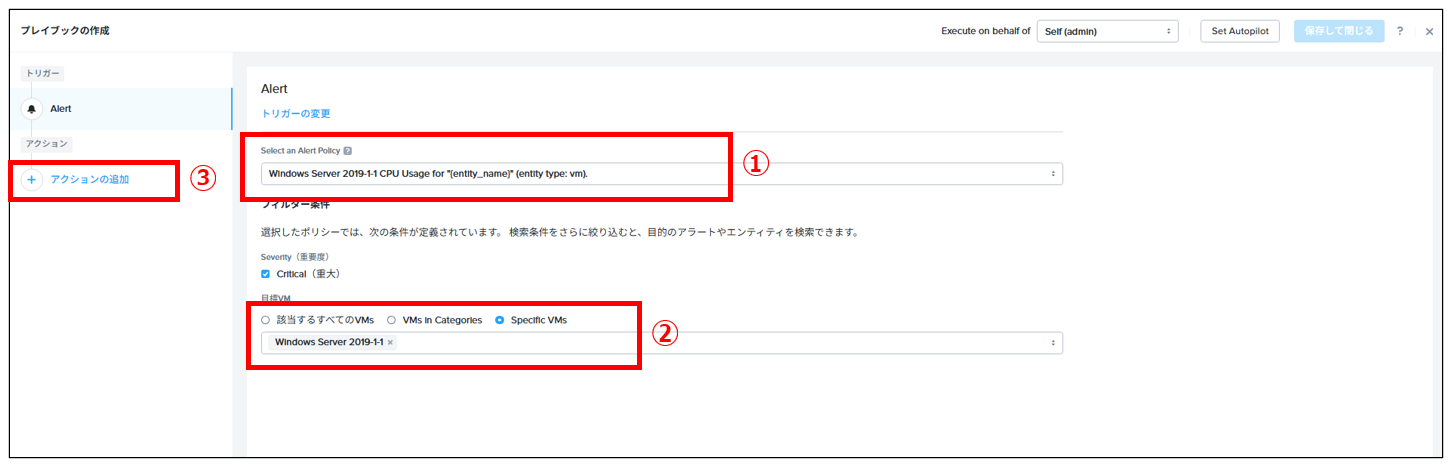
その後、PlaybookのトリガーとしてAlertを選択し、先ほど作成したアラートポリシーと対象VMを指定します。
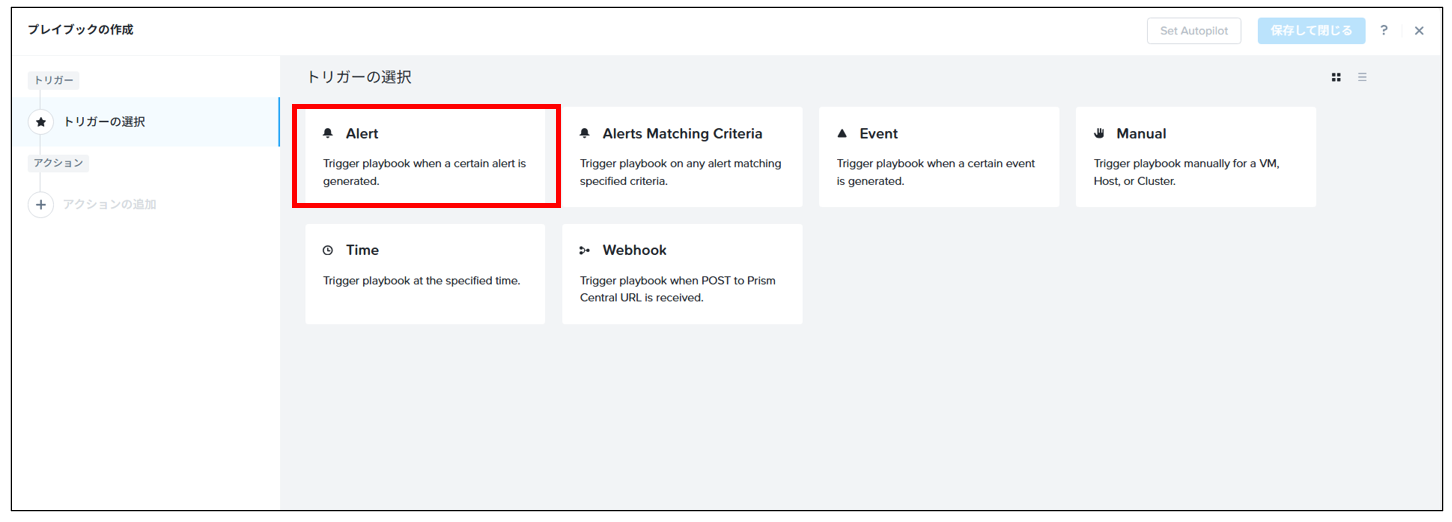
- Prism Central > Intelligent Operations > Playbooks > リスト > プレイブックの作成
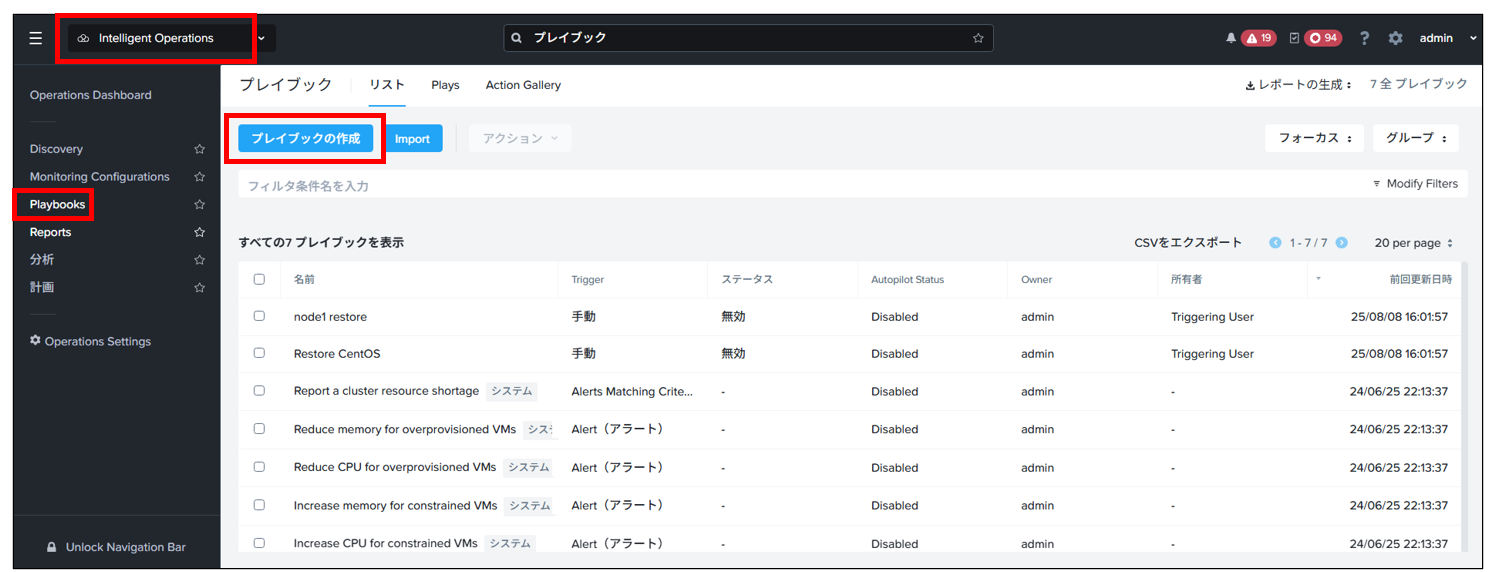
- トリガーの選択 > Alertを選択
- Alert Policy に先ほど作成したカスタムアラート、および対象のVM(例:Windows Server 2019-1-1)を指定の上、「アクションの追加」を選択
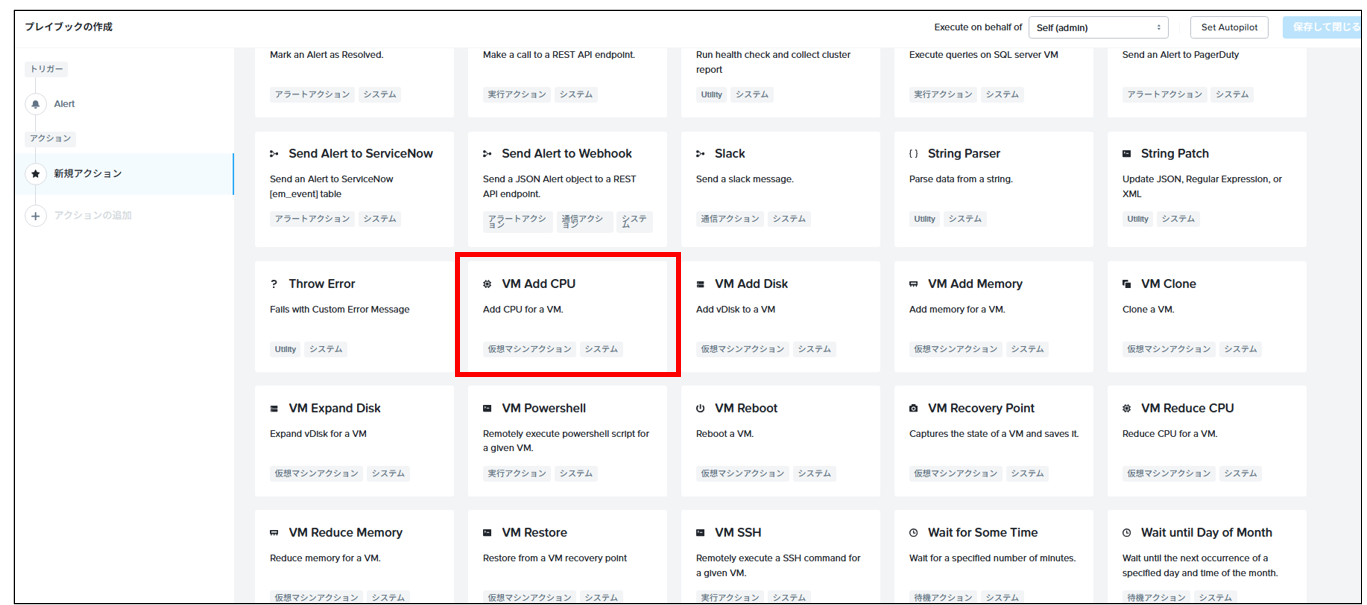
続いて、アクションとして「VM Add CPU」を追加し、CPUを追加する単位や、対象VMにおけるvCPUの上限値を設定します。
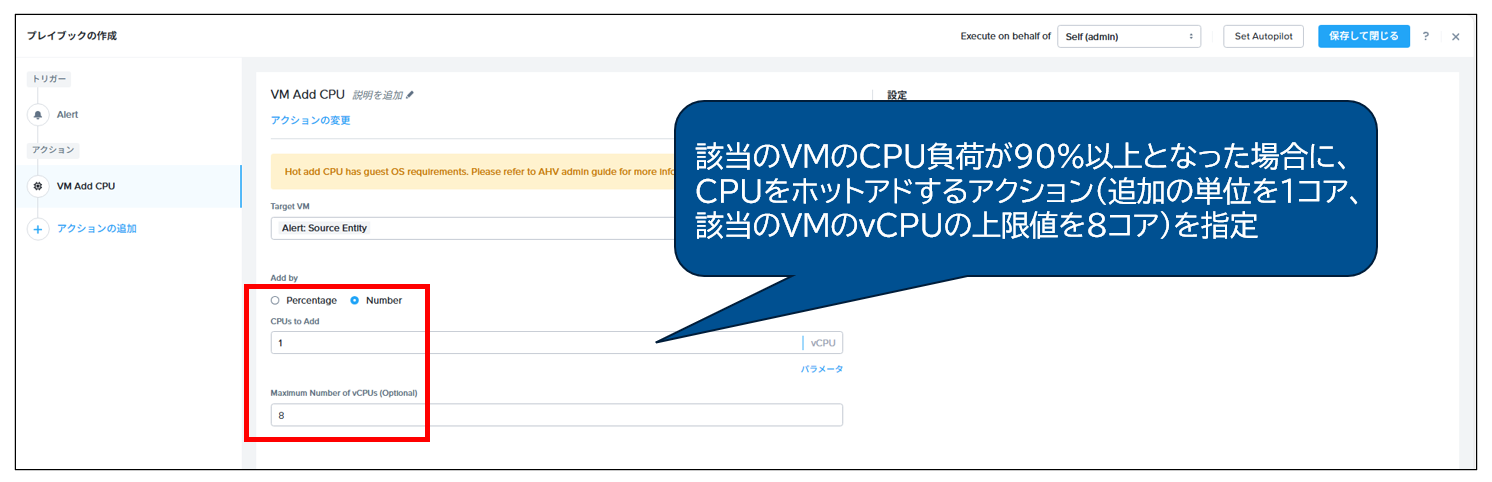
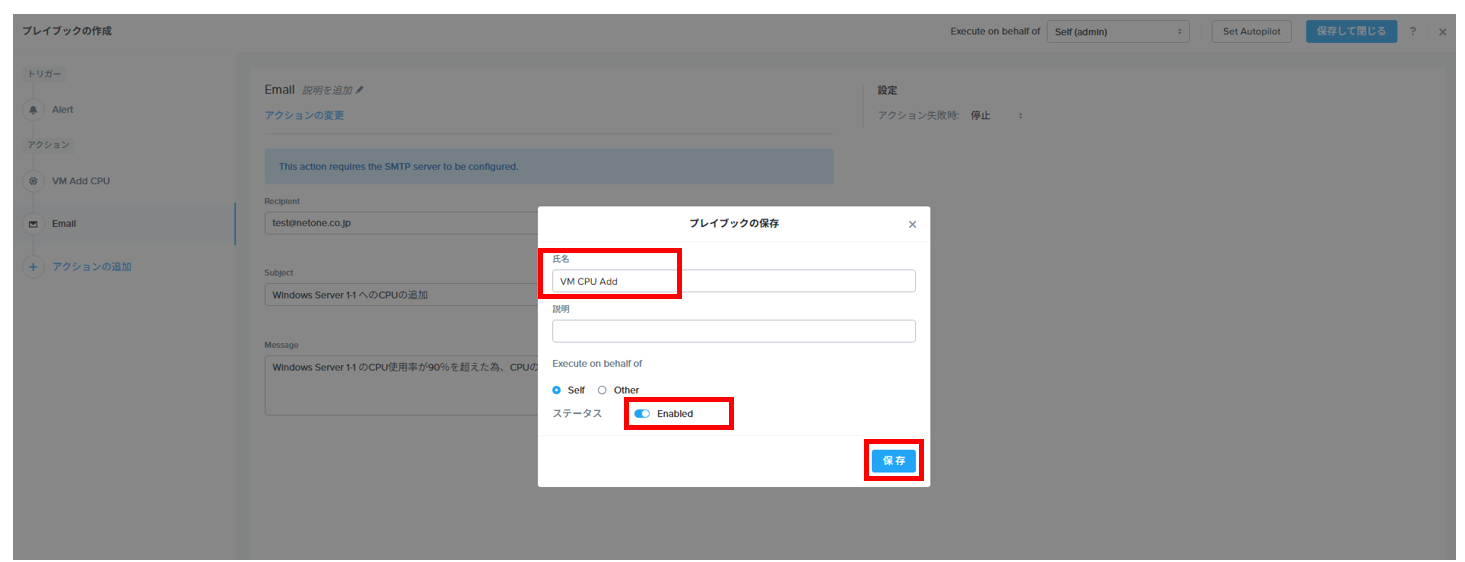
- プレイブックに名前をつけ、Enabled を選択の上「保存」
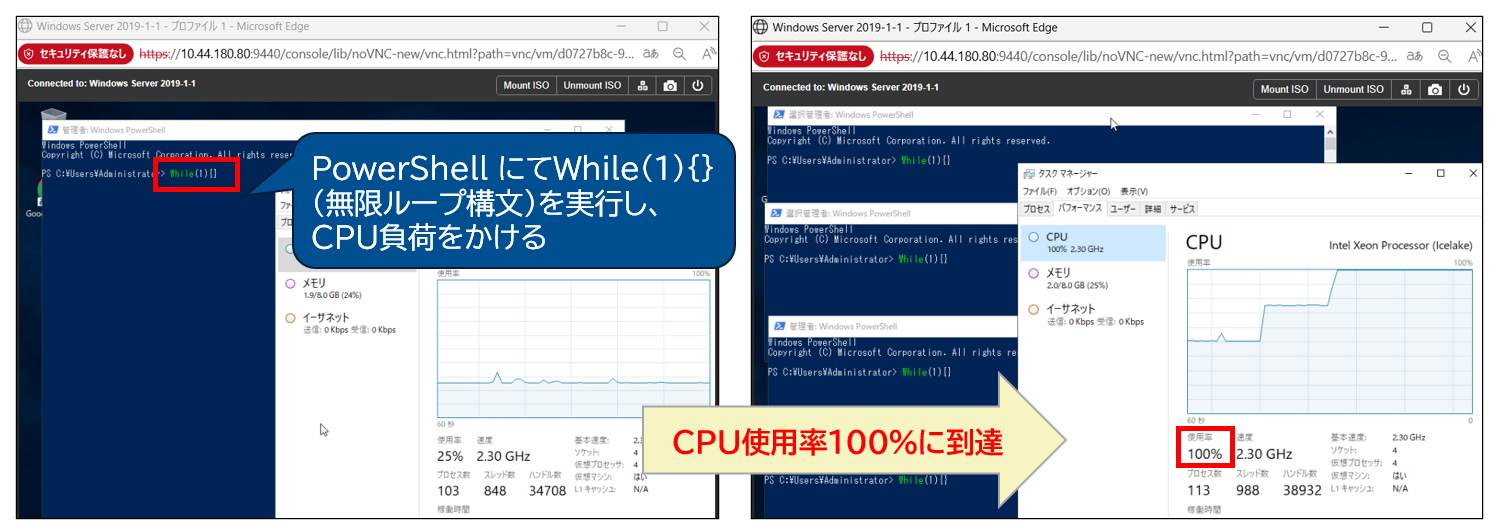
検証では、Windows Server 2019 VMに対してPowerShell の無限ループ処理を実行し、CPU使用率を100%まで上昇させました。その後、アラートが発生し、Playbook によりvCPUが4から5へHot Addされることを確認しています。
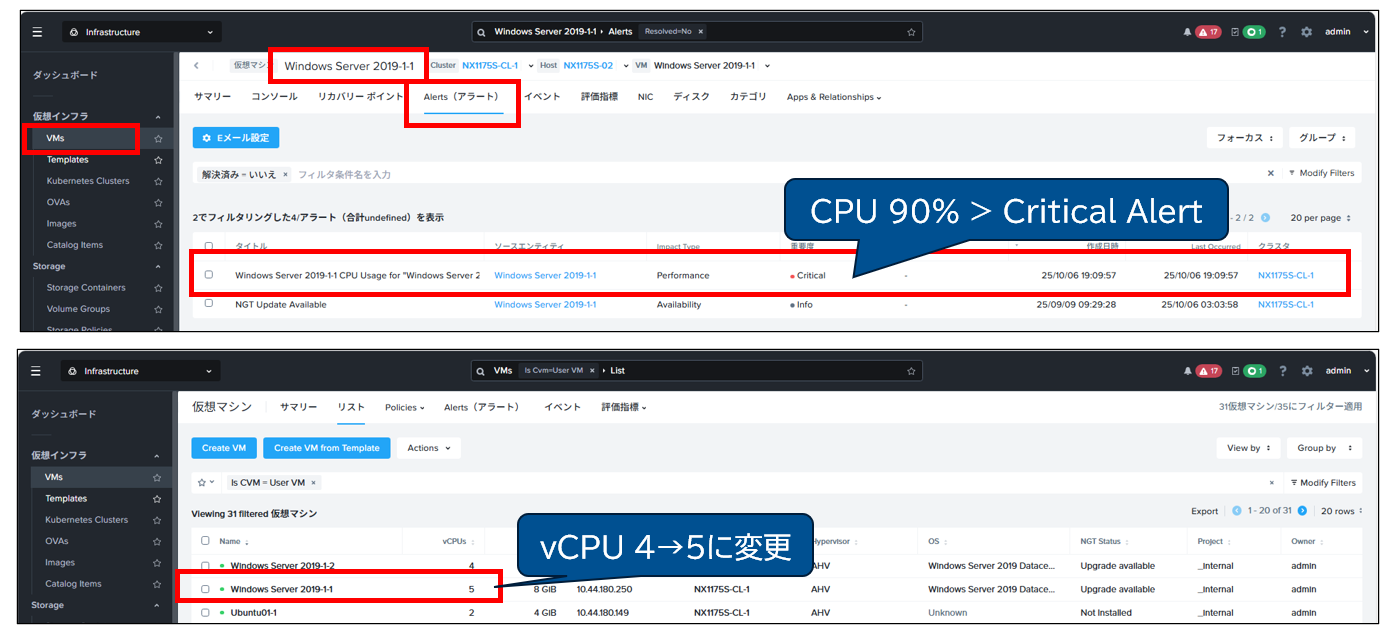
検証環境においては、CPU使用率が100%に到達してから13分後にAlertが発生し、vCPU がHot Add され4から5に増加しました。
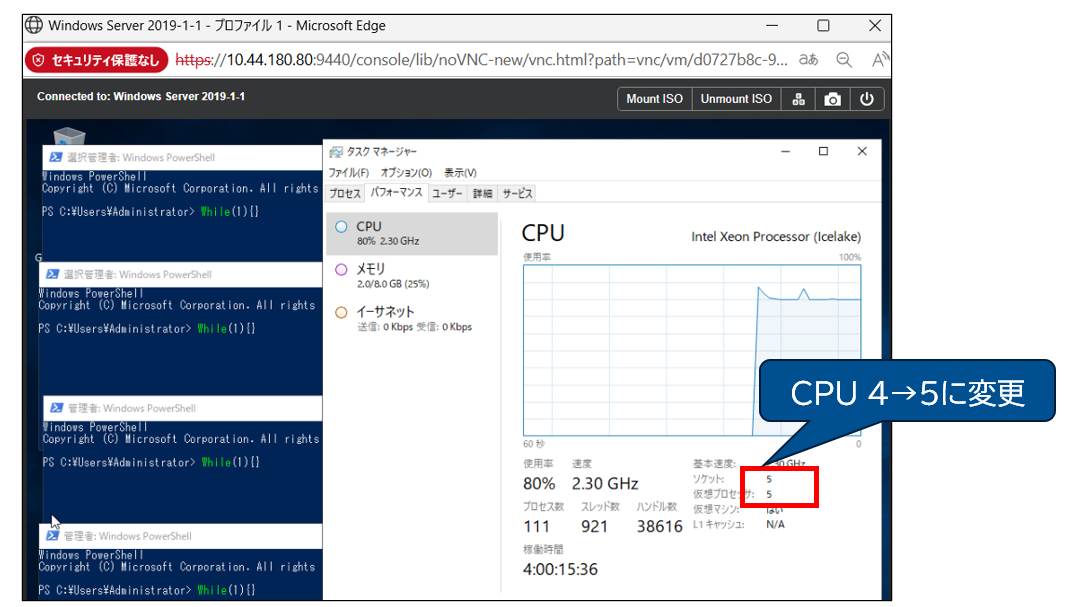
VMの電源状態に変更はなく、タスクマネージャー上でもCPU数が増加していることを確認しました。本検証では、Windows Server 2019 VM に対してCPU Hot Add が動作することを確認しましたが、ご利用にあたってはゲストOSや仮想化基盤側の対応状況、OSパッチ適用状況を事前に確認いただく必要があります。
このように、特定のアラートを契機としてVMのリソースを追加することで、突発的な負荷上昇に対する一次対応を自動化できます。ただし、リソース追加は根本対応ではなく、アプリケーション側の負荷要因や継続的なリソース需要もあわせて確認することが重要です。
まとめ
今回は、Nutanix Cloud Manager(NCM)Intelligent Operations によるNutanix環境の運用管理機能についてご紹介しました。
Intelligent Operations を利用することで、仮想マシンのリソース最適化、クラスタのキャパシティ予測、レポート作成、動的監視による異常検知、Playbook による運用自動化を、Prism Central から一元的に実施できます。特に、リソース利用状況の継続的な見直し、クラスタ増設時期の把握、運用レポートの共有、定型作業の標準化・自動化を行いたい環境において、有効な運用支援機能となります。
Playbook を利用する際は、自動化したい業務内容に合わせて、利用可能なアクションや連携方法を確認しながら設計することで、より効果的に活用できます。また、キャパシティ予測の推奨結果は過去の傾向に基づくため、実際の増設判断では、将来の利用計画やNutanix Sizer による詳細なサイジングと組み合わせて活用することが望まれます。
ネットワンシステムズでは、今後も Nutanix Cloud Platform を始めとした、最適な仮想化インフラ基盤の構築、運用をご支援いたします。
※本記事の内容は執筆者個人の見解であり、所属する組織の見解を代表するものではありません。
組織・製品等の名称は執筆時点のものです。